先看成品
最终效果
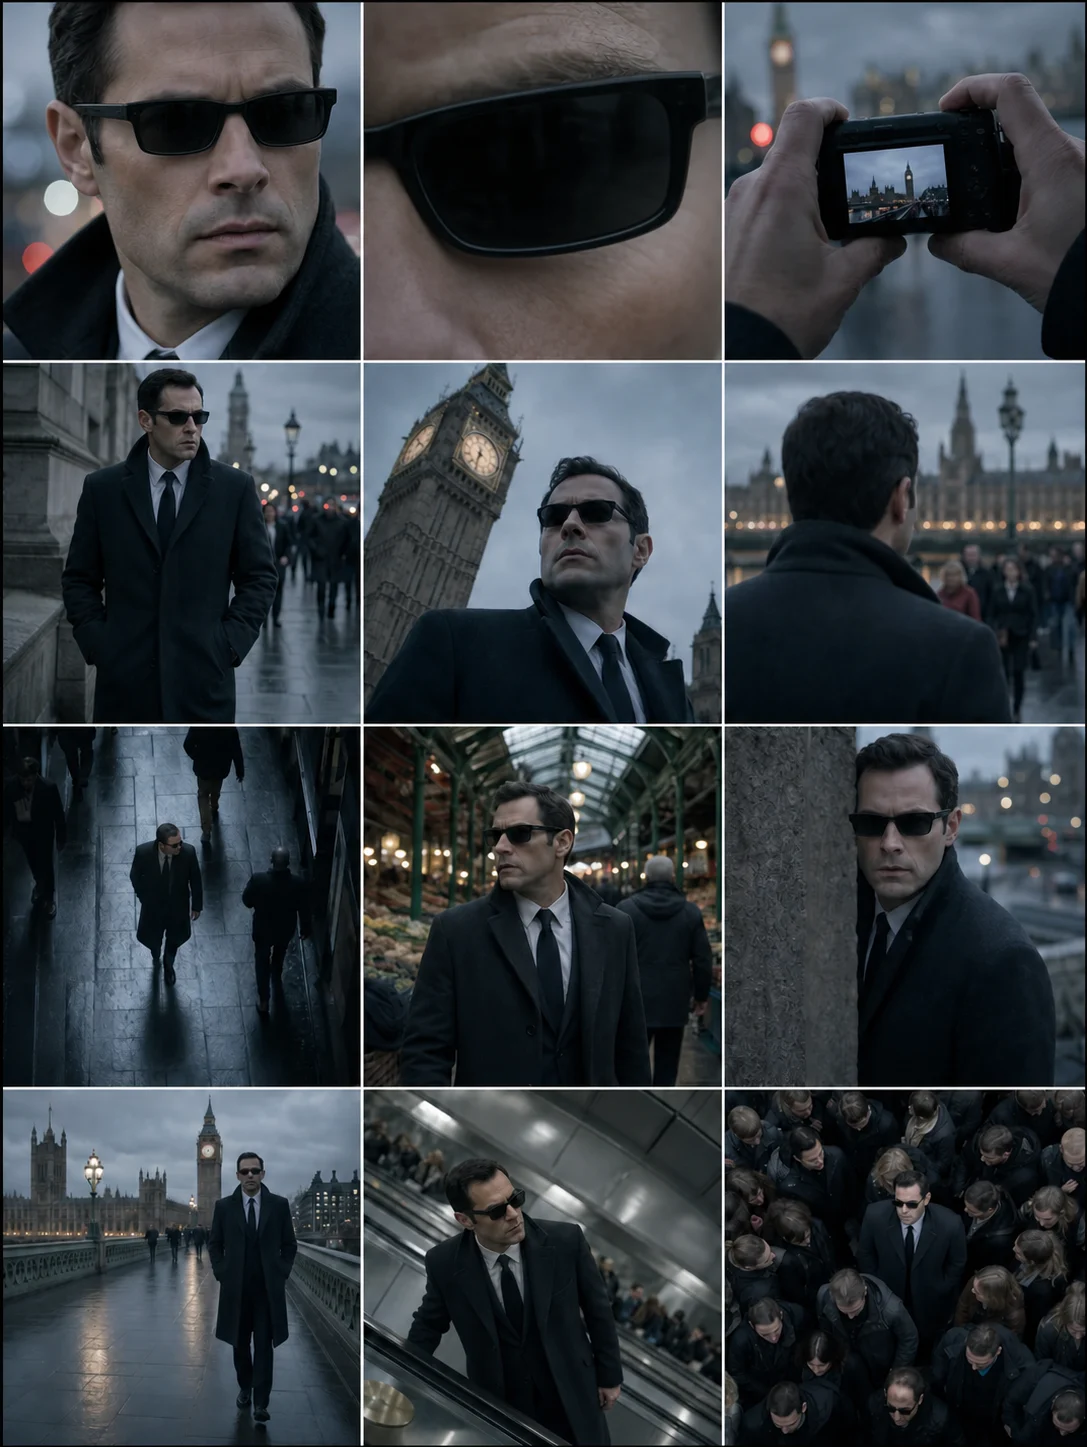
本篇练习制作一张完整的分镜图:整体为 3:4 竖幅,内部按照 3 列 × 4 行 排列十二格。同一个戴黑色墨镜、穿黑色风衣的男性出现在伦敦街道、市场、桥和地铁扶梯等环境里,每一格使用不同的电影镜位。
这张图的重点是一次比较十二种取景方式。它不是一段连续剧情,也不是十二张分别导出的高清图片。“镜位”指拍摄的位置和角度;“分镜图”把不同画面排列在一起,方便比较。
先看十二格各自要表现什么:
| 位置 | 镜位 | 画面中应该看到的内容 |
|---|---|---|
| 01 | 人物近景 | 男性面部、墨镜和黑色风衣领口清楚可见 |
| 02 | 眼部极特写 | 镜头贴近墨镜与眼部区域,保留人物身份特征 |
| 03 | 主观瞄准镜头 | 画面像从角色视角看向目标,手和瞄准动作进入前景 |
| 04 | 中景行走 | 男性在伦敦街道行走,能看见上半身和周围环境 |
| 05 | 低机位仰拍 | 镜头从下向上拍人物,背景出现大本钟 |
| 06 | 过肩镜头 | 从人物肩后看向前方,肩部和伦敦街景同时入画 |
| 07 | 高机位俯拍 | 镜头从人物上方拍摄,人物在城市空间中的位置清楚 |
| 08 | 市场跟拍 | 男性穿过市场,画面带轻微运动感 |
| 09 | 柱后揭示 | 人物从柱子后出现,前景遮挡制造窥视感 |
| 10 | 桥上大全景 | 威斯敏斯特桥与人物同时出现,环境占据更多画面 |
| 11 | 扶梯荷兰角 | 地铁扶梯画面倾斜,形成不稳定的谍战气氛 |
| 12 | 人群鸟瞰 | 从正上方看人物置身人群,人物仍能被识别 |
后面的提示词会按这张表逐格描述画面。
第 1 步
上传人物参考图
打开可以使用 GPT Image 1.5 的图像生成入口,新建一次生成。在输入框旁找到上传图片的位置,上传一张人物清晰、没有严重遮挡的男性照片。
最好选择能看清脸型、发型和上半身轮廓的图片。原图不一定要在伦敦,也不需要已经穿黑色风衣;它的作用是告诉模型“十二格里一直是这个人”。如果图片里有多人,先裁到只保留目标人物,否则模型可能在不同格里切换身份。
上传完成后,输入区应出现人物缩略图。这次先用一张人物图,便于检查每格是否保持同一人物。
第 2 步
写清人物特征
参考图能提供身份,但十二次改变景别和角度后,模型仍可能把发型、服装或年龄改掉。因此在提示词开头,用一句话把最容易辨认的特征再写一遍。
可以直接从这段开始,再按你的图片修改:
始终使用我上传的男性作为唯一主角。保持同一张脸、同一年龄、同一发型和相同身材比例。角色佩戴黑色墨镜,穿黑色长风衣,神情冷静而警觉。十二格中不要换人,不要改变服装颜色和发型。写完后检查三件事:有没有明确“同一角色”、有没有写出最醒目的服装、有没有指出不能变化的内容。这里不需要写人物履历或故事背景,因为最终图片只检验外观和镜位。
第 3 步
统一伦敦环境
接着告诉模型,十二格属于同一个伦敦谍战世界。环境描述要能覆盖街道、市场、威斯敏斯特桥、大本钟和地铁扶梯,又不能把每一格变成完全不同的年代或天气。
在人物描述后加入:
所有画面发生在当代伦敦,阴天、冷色环境光、潮湿路面,整体像写实谍战电影。可使用伦敦街道、繁忙市场、威斯敏斯特桥、大本钟和地铁扶梯作为背景,但十二格保持相同的天气、色调和时代。镜位会变化,但地点、天气和色调需要连贯。完成后,你的提示词中应同时出现具体地点和统一天气,而不是只有“电影感伦敦”这类模糊形容词。
第 4 步
写入十二个镜位
现在把十二格按从左到右、从上到下的顺序写进提示词。每一条同时包含景别或机位、人物动作和必要背景,模型才知道每格为什么不同。
按照从左到右、从上到下的顺序生成十二格:
1. 人物面部近景,墨镜和风衣领口清晰;
2. 眼部极特写,画面聚焦墨镜与眼部区域;
3. 主观瞄准镜头,角色的手和瞄准动作进入前景;
4. 中景,角色在伦敦街道向前行走;
5. 低机位仰拍角色,背景能看到大本钟;
6. 过肩镜头,从角色肩后看向伦敦街道;
7. 高机位俯拍角色在城市空间中移动;
8. 市场中的跟拍镜头,角色穿过人群和摊位;
9. 从柱子后方揭示角色,柱子作为前景遮挡;
10. 威斯敏斯特桥上的大全景,人物较小但仍可识别;
11. 地铁扶梯上的荷兰角镜头,画面明显倾斜;
12. 人群中的鸟瞰镜头,从正上方看见角色。
不要把“近景、极特写、高机位、鸟瞰”写成一串没有动作的关键词。上面的写法让每个术语都对应一幅能看懂的画面。写完后数一遍,必须正好十二条;少一条会空格,多一条容易打乱网格顺序。
第 5 步
加入电影摄影效果
最后补充统一的摄影语言。它负责让十二格看起来来自同一部电影,而不是十二种互不相关的生成风格。
写实电影摄影,克制的冷灰色调,高对比但保留暗部细节,自然景深,真实镜头质感。行走、市场跟拍等运动镜头可有轻微运动模糊,静止特写保持面部和服装清晰。光线方向、人物外观和风衣材质在十二格中保持一致。“轻微运动模糊”只用于有动作的格子。所有格都强行模糊,会让眼部特写和人物身份无法检查;所有格都极锐利,又会削弱跟拍镜头的速度感。
第 6 步
生成并检查网格
把人物、环境、十二镜位和摄影效果合并后,在结尾写清最终版式:
最终只输出一张 3:4 竖幅图片,内部为严格的 3 列 × 4 行网格,共十二格。每格边界清楚,顺序与上面的 1—12 完全一致。所有格必须是同一名男性角色,不生成标题、说明文字、水印或额外面板。提交生成。结果出现后,不要只看“像不像电影”,按下面的顺序逐格核对:
| 检查项 | 正确结果 | 如果不对,下一次怎么改提示词 |
|---|---|---|
| 版式 | 一张图、3 列 × 4 行、正好十二格 | 把“严格网格、共十二格、不要额外面板”放到提示词开头和结尾 |
| 人物 | 十二格都是参考图中的同一男性 | 缩短环境描写,重复脸、发型、墨镜和风衣不可变化 |
| 镜位 | 十二格能逐一对应表格中的镜位 | 为混淆的格子补上机位方向、主体动作和背景物 |
| 伦敦环境 | 大本钟、桥、市场和扶梯出现在指定格中 | 把地点写回对应编号,不要只放在总环境描述里 |
| 摄影风格 | 色调和光线统一,运动格有适量动态感 | 删除互相冲突的风格词,只保留一种冷色谍战电影方向 |
当一张图同时满足十二格数量、同一人物、指定镜位和统一伦敦气氛时,这篇教程就完成了。最终保存的是这张 3×4 分镜网格,保存前再次检查人物、镜位和版式。